検索結果に出したくないページがあるので、robots.txtでブロックしました。それなのに、いまも自社のURLが検索に出てきます。中小企業の経営者の方から、こうしたご相談をいただくことがあります。
原因はほとんどの場合、robots.txtとnoindexの役割を取り違えていることです。この2つは名前が似ていますが、やっていることがまったく違います。
この記事では、robots.txtとnoindexの違い、なぜブロックしたのに検索に出てしまうのか、そして「検索に出したくない」を目的別に正しく実現する方法を、専門用語をできるだけ避けてご説明します。
お問い合わせ完了ページ、会員限定の案内、テスト用に作ったページ、サイト内検索の結果ページ。中小企業のサイトにも「表には出したくないURL」は意外とたくさんあります。
筆者はWeb制作とSEO支援に10年以上携わり、延べ1,000件以上のサイトを見てきましたが、この取り違えは本当によく見かけます。制作会社に設定を任せている場合でも、考え方を知っていれば「これはrobots.txtではなくnoindexですよね」と確認できます。
なお、ここで書いている内容はすべて、Googleが検索セントラルで公開している公式ドキュメントにそっています。
記事執筆者:認定SEOコンサルタント 三田健司
robots.txtとnoindexは、役割がまったく違う
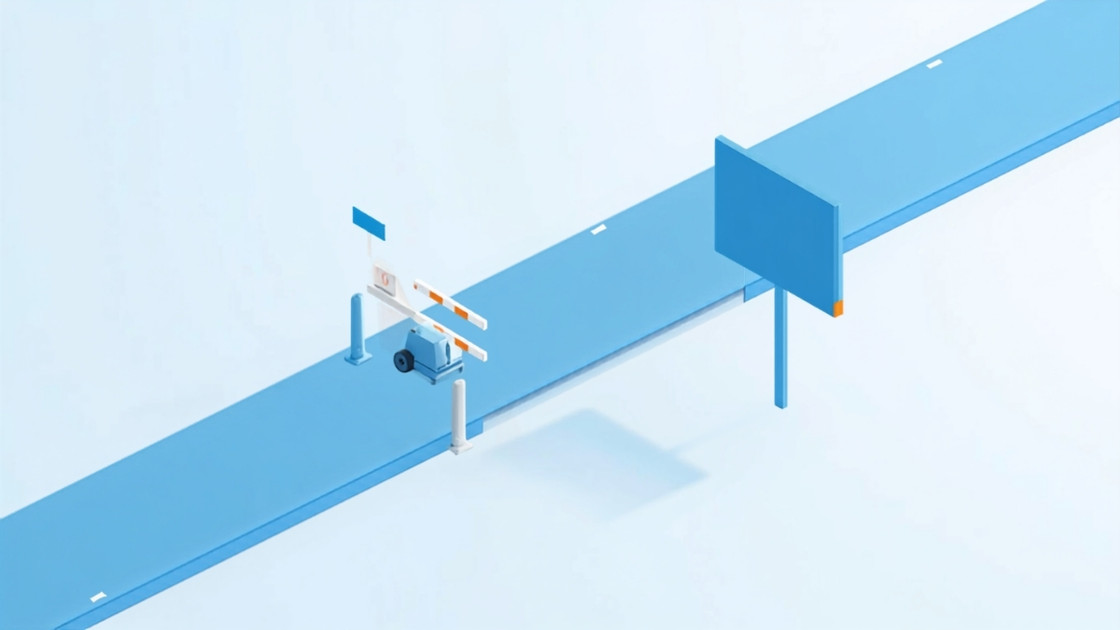
robots.txtは「入っていいですか」の交通整理
robots.txtは、サイトの一番上の階層に置く小さなテキストファイルです。Googleなどの検索エンジンのロボットに対して「このフォルダには入らないでください」と伝えるために使います。
Googleの公式ドキュメントでは、robots.txtの役割は「主にサイトへのクローラーのトラフィックを管理するため」だと説明されています。つまり、アクセスが集中してサーバーに負担がかかるのを防いだり、重要でないページを巡回させないようにしたりするための仕組みです。
道路にたとえるなら、通行止めの看板と遮断バーです。ロボットはそこから先へ進めなくなります。
ただし、通行止めにしたからといって、その先に建物があるという事実まで消えるわけではありません。ここが最大のポイントです。
noindexは「検索結果に出さないでください」の指示
一方のnoindexは、ページそのものに書き込む指示です。HTMLの頭の部分に1行入れておくと、Googleはそのページを検索結果に表示しなくなります。
公式ドキュメントでのnoindexの説明は「このページ、メディア、リソースを検索結果に表示しない」です。指定しなければ、ページは検索結果に出る可能性があります。
こちらは通行止めではなく、店先に出した「掲載はお断りします」という札に近いものです。ロボットは中に入って札を読み、その上で掲載を見送ります。
検索結果から消したいなら、必要なのはrobots.txtではなくnoindexのほうです。
Google公式が「robots.txtは隠す仕組みではない」と明記している
これは筆者の解釈ではなく、Googleがはっきり書いていることです。robots.txtの紹介ページには「ウェブページをGoogleから除外するための仕組みではありません」と太字で書かれています。
そして続けて「ウェブページをGoogleに表示しないようにするには、noindexでインデックス登録をブロックするか、ページをパスワードで保護してください」と、代わりの方法まで案内されています。
さらに同じページには警告として、robots.txtをウェブページを隠す手段として使わないでください、という一文も置かれています。PDFなど、Googleが読めるテキスト形式のファイルも同じ扱いです。
公式がここまで念を押しているのは、それだけ取り違えが多いからだと考えられます。
ひとことで言うと「通行止め」と「掲載お断り」
整理すると、robots.txtは「クロール(巡回)を止めるもの」、noindexは「インデックス(検索結果への登録)を止めるもの」です。止めている工程がそもそも違います。
検索エンジンは、クロールして中身を読み、それをインデックスに登録し、検索されたときに順位を決めて表示する、という順番で動いています。robots.txtは1番目、noindexは2番目に効きます。
この順番を頭に入れておくと、次にご説明する「ブロックしたのに検索に出る」という現象の理由がすっきり理解できます。
robots.txtで止めたのに、検索に出てしまう理由
外部からリンクされていれば、中を見なくてもURLは載る
Googleの公式ドキュメントには、robots.txtの限界として次のような説明があります。robots.txtで拒否したURLでも、ウェブ上の他の場所からリンクされていれば、見つけてインデックスに登録することがある、というものです。
この場合、Googleはページの中身を読んでいません。読んでいないのに、URLそのものと、そのページに向けられたリンクの文言など、公開されている情報だけで検索結果に載ってしまいます。
先ほどの道路のたとえで言えば、通行止めにしても、近所の人が「あの奥に建物がある」と話していれば、その存在は地図に載る、ということです。
ですから、他社サイトやSNSから1本でもリンクされる可能性があるページは、robots.txtだけでは守れません。
説明文のない検索結果は、この状態のサインです
自社のURLが検索結果に出ているのに、その下の説明文が空っぽだったり「このページの情報は取得できません」といった表示になっていたりしたら、まさにこの状態です。
公式ドキュメントでも「robots.txtファイルでブロックされているウェブページのURLは検索結果に表示される可能性がありますが、検索結果には説明が表示されません」と説明されています。
会社名やサービス名で検索したとき、こうした説明文のない結果が混ざっていないか、一度確認してみてください。見た目の印象という意味でも、あまり気持ちのいいものではありません。
直し方は、robots.txtのブロックを外し、代わりにnoindexを入れることです。順序が逆だと直りません。
いちばんやってはいけない組み合わせが「Disallow+noindex」
取り違えに気づいた方が次にやりがちなのが、robots.txtのブロックを残したまま、ページにnoindexも入れる、という「念のため両方」の対応です。
これは効きません。むしろ逆効果です。Googleの公式ドキュメントには「robots.txtファイルでページのクロールが拒否されている場合、インデックス登録や配信ルールに関する情報は見つけられず、無視されます」と書かれています。
noindexはページの中に書いてある指示なので、中に入れなければ読めません。通行止めにした道の奥に「掲載お断り」の札を立てても、誰も読まないのと同じです。
同じドキュメントには「インデックス登録ルールや配信ルールを遵守させる必要がある場合、それらのルールを含むURLのクロールを拒否することはできません」とも明記されています。noindexを入れるなら、そのページはクロールできる状態にしておく必要があります。
サイト内検索ページが勝手に量産される、という実例
2026年7月には、この取り違えが実害につながった事例が海外で話題になりました。あるネットショップで、サイト内検索の入力欄にスパム業者が宣伝目的の言葉を打ち込み、その検索結果URLが大量にインデックスされてしまった、というものです。
サイト側は検索結果ページをrobots.txtでブロックしていましたが、インデックスは止まりませんでした。Googleの担当者が実際のrobots.txtを確認して原因を指摘し、対処法として「robots.txtでブロックするのではなく、検索結果ページにnoindexを出す設定にすること」が案内されています。
サイト内検索の機能を持つサイトは、中小企業でも珍しくありません。WordPressの場合、主要なSEOプラグインは検索結果ページを初期設定でnoindexにしてくれるものが多いので、まずはその設定が有効になっているかを確認してみてください。
なお「出したいのに出ない」という逆のお悩みについては、別の記事で原因を整理しています。
2026年のrobots.txtで見落としやすい2つの落とし穴
落とし穴1|Googlebot向けの行があると、全員向けの行は読まれない
robots.txtには、どのロボット向けの指示かを書く行があります。全員向けなら「User-agent: *」、Google向けなら「User-agent: Googlebot」と書きます。
ここに落とし穴があります。Googlebot向けのまとまりが1つでもあると、Googleはそのまとまりだけを読み、全員向けのまとまりは一切見ません。
Googleの担当者は2026年7月、実際にこの誤りで困っていたサイトについて「robots.txtでは、より限定的なルールが優先されます。User-agent: Googlebotのまとまりがあれば、Googleはそこだけを使います」と説明しています。
つまり、全員向けに書いた10行のブロックがあっても、その下にGooglebot向けの2行を足した瞬間、Googleにとっては「その2行がすべて」になります。追加したつもりが、実は上書きしていた、ということが起こります。
同じルールを使いたいなら、user-agentを並べて書く
対処は2つあります。1つは、全員向けに書いた内容をGooglebot向けのまとまりにもそのまま複製することです。
もう1つは、同じルールを適用したいロボットのuser-agentを続けて並べ、その下にDisallowをまとめて書く方法です。Googleの担当者もこの書き方を推奨しています。
いちばん安全なのは、そもそもGooglebot専用のまとまりを作らないことです。特定のロボットだけに別の指示を出す必要がないなら、全員向けの1つだけにしておけば、この事故は起きません。
自社のrobots.txtは、ブラウザのアドレス欄にドメイン名と「/robots.txt」を続けて入力すれば誰でも見られます。まずは開いて、User-agentの行がいくつあるかを数えてみてください。
落とし穴2|robots.txtに書いても、効かないルールがある
robots.txtには、昔から使われているのにGoogleは対応していない、という書き方がいくつもあります。2026年9月時点の公式仕様では、Googleがサポートしているのはuser-agent、allow、disallow、sitemapの4つだけで、それ以外の項目はサポートしていないと明記されています。
なかでも注意したいのが、robots.txtに「Noindex:」と書いてもGoogleは無視する、という点です。Googleは2019年7月の公式ブログで、noindex、nofollow、crawl-delayといった記述のサポートを終了すると告知しています。
noindexはページ側に書くものであって、robots.txtに書く指示ではありません。名前が同じなので、ここも取り違えが起きやすい場所です。
なお、2026年4月には、Googleのゲイリー・イリェーシュ氏が、実際によく使われているサポート外の書き方を公式ドキュメントに一覧として載せる計画を明らかにしています。ただし2026年9月時点で、公式仕様ページにその一覧はまだ掲載されていません。
効かない行が書いてあったからといって、ペナルティを受けるわけではありません。ただ、効いていない行がファイルに残っていると、トラブルが起きたときの原因調査が難しくなります。見つけたら消しておくのが無難です。
content-signalは、GoogleもBingも従っていない
サポート外の書き方のなかでも、よく話題になるのがcontent-signalです。2025年9月にCloudflareが提唱したもので、AIによる学習や回答への利用について、サイト側の意思を示すための書き方として提案されました。
ただ、2026年9月時点で、この指示に従うと表明した主要な検索エンジンやAI企業はありません。Googleの担当者も2026年7月に「content-signalを使っているクローラーやAIは把握していない」と述べており、GoogleもBingも未知の項目として無視します。
AIクローラーへの対応は、robots.txtで学習用のロボットを拒否するなど別の方法があります。そちらは記事を分けて整理していますので、あわせてご覧ください。
robots.txtは、サブドメインとプロトコルごとに別物です
もう1つ、見落としやすい性質があります。robots.txtは、wwwのあり・なし、httpとhttpsで、それぞれ別のファイルとして扱われます。
本体のサイトとは別にブログ用のサブドメインを使っている場合、そちらのrobots.txtは完全に別管理です。本体で設定したつもりが、サブドメイン側には何も書かれていなかった、ということが起こります。
サブドメインを使っているなら、それぞれのrobots.txtを開いて中身を見比べておいてください。1分で終わる確認です。
目的別|検索に出したくないページの正しい対処法
①社外に絶対に見せたくない|パスワードで守る
取引先向けの資料、社内マニュアル、公開前の新サービス紹介。こうした「URLを知られること自体が困る」ものは、noindexでは足りません。
Googleの公式ドキュメントも、情報をクローラーから確実に守りたい場合はサーバー上でファイルをパスワード保護するのが最善だと説明しています。noindexはあくまで「検索結果に出さない」だけで、URLを知っている人は誰でも閲覧できます。
加えて、robots.txtの指示に従うかどうかはロボット側の判断だ、という点も公式に明記されています。Googlebotのような行儀のよいロボットは従いますが、すべてのロボットが従うとは限りません。
機密性のあるものは、技術的な合図ではなく、認証で守ってください。WordPressなら固定ページのパスワード保護機能でも最低限の対応はできます。
②見られてもいいが、検索には出したくない|noindex
お問い合わせ完了ページ、キャンペーンのサンクスページ、印刷用ページ、タグ一覧やアーカイブなど中身が薄いページ。ここがnoindexの出番です。
お問い合わせ完了ページが検索に出ていると、フォームを通さずにそのページへ直接来た人が「送信できた」と誤解する可能性があります。地味ですが、機会損失につながる問題です。
この場合、robots.txtでのブロックは不要です。というより、してはいけません。クロールできないとnoindexが読まれないからです。
③そもそも不要なページ|削除して404か410を返す
終了したキャンペーン、取り扱いをやめた商品、古いお知らせ。中身ごと不要になったものは、noindexで隠すより削除してしまうほうがすっきりします。
削除したページは、404か410という「ここにはもうありません」という応答を返すようにします。行き先のないページを無理にトップページへ転送するのは、Googleが推奨していない対応です。
ただし、内容を引き継ぐ後継ページがある場合は、301リダイレクトで案内したほうが検索評価を引き継げます。判断の基準は記事を分けてまとめています。
④似たページが増えすぎた|canonicalでまとめる
色違いの商品ページ、並び替えや絞り込みで生まれるURL、パラメータ付きのURL。これらは「消したい」のではなく「1本にまとめたい」ケースです。
こうしたときはnoindexよりcanonicalが向いています。代表となるURLを1つ指定して、評価をそこに集約する考え方です。
noindexで片っ端から消してしまうと、まとまるはずだった評価まで消えてしまうことがあります。目的が「整理」なら、まずcanonicalを検討してください。
⑤PDFや画像を出したくない|X-Robots-Tagを使う
PDFの資料や見積書のひな形が検索に出てしまう、というご相談もよくあります。PDFにはHTMLの頭の部分がないので、noindexのタグを書き込めません。
この場合はX-Robots-Tagという仕組みを使います。サーバーの設定ファイルに数行足すことで、特定の拡張子のファイルすべてにnoindexを適用できます。
公式ドキュメントにも、Apacheの場合とNGINXの場合それぞれの書き方が例として載っています。サーバーの設定に触る作業なので、制作会社やサーバー管理者に依頼するのが安全です。
なお、画像や動画そのものを検索結果に出したくないだけなら、robots.txtでのブロックも公式に認められた方法です。メディアファイルについてはrobots.txtが有効に働きます。
早見表|やりたいことと、選ぶ手段
ここまでを1つにまとめます。「誰にも見せたくない」ならパスワード保護、「検索結果から消したい」ならnoindex、「もう要らない」なら削除して404か410、「重複を整理したい」ならcanonical、「PDFや画像を出したくない」ならX-Robots-Tagかrobots.txtです。
そしてrobots.txtの本来の役割は、サーバーへの負担を抑えることと、見てもらう必要のない場所にロボットを立ち入らせないことの2つです。検索結果のコントロールに使うものではありません。
迷ったら「これはクロールの話か、インデックスの話か」と自問してみてください。それだけで、ほとんどの場合は正しい手段にたどり着けます。
noindexの入れ方|WordPress・HTML・サーバーの3通り
WordPressなら、SEOプラグインのスイッチ1つ
WordPressをお使いなら、HTMLを触る必要はありません。投稿や固定ページの編集画面を下までスクロールすると、SEOプラグインの設定欄があります。
そこに「検索結果に表示しない」「このページをnoindexにする」といった項目があるので、それをオンにして更新するだけです。プラグインが自動でタグを書き込んでくれます。
Googleの公式ドキュメントでも、WixやWordPress、Bloggerのようなサービスを使っている場合は、HTMLを直接編集するのではなく、その管理画面の検索設定を使うよう案内されています。
注意したいのは、WordPressの「設定」→「表示設定」にある「検索エンジンでの表示」のチェックです。ここにチェックを入れるとサイト全体が検索に出なくなります。テスト中に入れたまま公開してしまう事故が、いまだに後を絶ちません。
HTMLを直接さわる場合の書き方
自作のサイトやランディングページなど、HTMLを直接編集できる場合は、ページの先頭にあるheadというまとまりの中に1行足します。
書くのは、metaタグのname属性にrobots、content属性にnoindexを指定した1行です。この書き方は、すべての検索エンジンのロボットに対する指示になります。
Googleだけに指示したいときは、nameの値をrobotsからgooglebotに変えます。ただし中小企業のサイトで、Googleだけ個別に指定する必要が出る場面はほとんどありません。
ちなみに公式ドキュメントによれば、Googleはhead内でなく本文中に書かれたrobotsのmetaタグも尊重するとされています。とはいえ、素直にhead内へ書くのが確実です。
noindexとnofollowを一緒に書くときの注意
noindexと並べて、nofollowという指示を書く例をよく見かけます。nofollowは「このページ内のリンクをたどらないでください」という意味です。
2つをカンマ区切りで並べて書くこともできますし、noneと書けば両方を指定したのと同じ扱いになります。
ただ、両方を付けるかどうかは慎重に判断してください。そのページから他の重要なページへリンクしている場合、nofollowを付けるとGoogleがその先をたどらなくなります。
検索結果に出したくないだけなら、noindexだけで十分です。迷ったらnoindex単独にしておくのが安全です。
複数の指示がぶつかったときは、厳しいほうが勝つ
プラグインとテーマ、あるいはサーバー設定とページ内のタグで、違う指示が同時に出てしまうことがあります。
公式ドキュメントには、robotsのルールが矛盾する場合はより制限の強いルールが適用されると書かれています。例えばmax-snippetで文字数を指定していても、同時にnosnippetがあればnosnippetが優先されます。
これは裏を返せば、どこかに強い指示が1つ紛れ込んでいるだけで、意図しない状態になり得るということです。出したいページが出ないときは、この重複を疑ってみてください。
入れたあとに、robots.txtで塞がないこと
ここまで何度か触れましたが、大切なので最後にもう一度書きます。noindexを入れたページは、クロールできる状態のままにしておいてください。
そして、検索結果から消えたことを確認できるまでは、robots.txtに追記しないことです。消えたあとでブロックを足す必要も、実務上はほとんどありません。
すでに登録されているページの場合、noindexが反映されるまでには、Googleがそのページを再び巡回するのを待つ必要があります。数日から数週間かかることもあります。
「消す」のではなく「見せ方を変える」という選択肢
nosnippet|説明文を出さない
ページは検索結果に出したいけれど、内容の一部が抜き出されて表示されるのは避けたい。そういうときはnosnippetという指示があります。
これを入れると、検索結果にテキストの説明文や動画のプレビューが出なくなります。静止画のサムネイルは、そのほうが分かりやすい場合に表示されることがあります。
2026年の実務で重要なのはここからです。公式ドキュメントによれば、nosnippetはAIによる概要とAIモードへの直接の入力として使われることも防ぐとされています。AI検索に自社の文章を使われたくない場合の選択肢の1つです。
ただし、説明文が出ない検索結果はクリック率が落ちる可能性が高いことも、あわせて考えてください。集客を目的としたページには基本的に向きません。
max-snippet|文字数の上限を決める
すべて止めるのではなく、上限を決めたいときはmax-snippetを使います。数字を指定すると、その文字数までしか説明文に使われません。
0を指定するとnosnippetと同じ扱い、マイナス1を指定すると「上限なし、Googleにまかせる」という意味になります。集客目的なら、マイナス1にしておくのが一般的です。
この指定も、AIによる概要やAIモードでコンテンツがどれだけ使われるかに影響します。ニュース系サイトが引用量をコントロールするために使う、という文脈で語られることが多い機能です。
data-nosnippet|ページの一部だけ隠す
ページ全体ではなく、特定の1文や1段落だけ検索結果に出したくない、という場合もあります。社内向けの注記や、価格の但し書きなどです。
その場合はdata-nosnippetという属性を、隠したい部分を囲むspan、div、sectionのいずれかのタグに付けます。この3種類以外のタグでは効きません。
注意点として、公式ドキュメントはJavaScriptで後からこの属性を付け外しすることを避けるよう案内しています。タグの閉じ忘れがあると、それ以降の内容がすべて対象になってしまう点にも気をつけてください。
期限付きで消したいならunavailable_after
期間限定のキャンペーンページや、募集終了が決まっている求人ページには、unavailable_afterという指定が使えます。日時を指定すると、それ以降は検索結果に表示されなくなります。
公式ドキュメントによれば、指定した日時を過ぎるとGooglebotはそのURLのクロール頻度も大きく下げます。終了後にページを消し忘れて、古い情報のまま検索に出続ける、という事故を防げます。
ページ内の画像だけ検索に出したくない場合は、noimageindexという指定もあります。写真の二次利用が気になる業種では検討の余地があります。
AI検索だけ出したくないなら、サーチコンソールに設定がある
通常の検索結果には出したいけれど、AIによる概要やAIモードには使われたくない。そうした希望に対しては、サーチコンソール側に専用の設定が用意されています。
「検索の生成AI」という設定で、2026年8月31日に全世界のすべてのサイトへの展開が完了しています。選べるのは「含める」「除外する」「親プロパティから継承」の3つで、既定値は「含める」です。
ただし、親プロパティを持つ子プロパティは、既定が「親から継承」になります。上位のプロパティで「除外する」が選ばれていれば、子のほうも除外されるという点にご注意ください。
なお、この設定はAIの学習には影響しません。学習の制御はGoogle-Extendedという別の仕組みです。除外すると、AI検索からの表示回数もアクセスも受け取れなくなります。
判断材料を整理した記事がありますので、検討される場合はこちらをご覧ください。
設定したあとに必ずやる、5つの確認手順
手順1|URL検査で、いまの状態を見る
サーチコンソールの上部にある検査ボックスに、対象のURLをそのまま貼り付けてEnterを押します。数秒で、そのURLの現在の状態が表示されます。
「URLはGoogleに登録されています」と出ていれば、まだ検索結果に出ている状態です。noindexが効いていれば、やがて「noindexタグによって除外されました」という表示に変わります。
「robots.txtによりブロックされましたが、インデックスに登録しました」と出ていたら、この記事で説明した典型的な取り違えの状態です。robots.txtのブロックを外してください。
手順2|robots.txtレポートで、読み込まれた中身を確かめる
サーチコンソールには、Googleが実際に読み取ったrobots.txtを確認できるレポートがあります。設定メニューの中にあり、いつ取得されたか、内容に問題がないかを見られます。
自分が編集した内容と、Googleが読んでいる内容が一致しているかを見比べてください。キャッシュの関係で、編集直後は古い内容が表示されていることがあります。
ここでUser-agentの行がいくつあるかも確認できます。先ほどの落とし穴1のチェックにも使えます。
手順3|site:検索で、残っていないか目視する
Googleの検索窓に「site:」と自社のドメイン名を続けて入力すると、インデックスされているページがおおよそ一覧で出てきます。
この一覧を眺めて、出したくないURLが混ざっていないかを確認します。説明文が空欄のものがあれば、robots.txtでブロックされたまま登録されている候補です。
なお、この検索結果の件数は正確な数ではありません。目視で気づくための手段として使ってください。
手順4|急いで消したいときは削除ツールを併用する
noindexは、Googleが再びそのページを巡回するまで効きません。誤って公開してしまった情報など、すぐに消したい場合は間に合わないことがあります。
そのときはサーチコンソールの削除ツールを使います。ただしこの効果は一時的で、およそ6か月で元に戻ります。
削除ツールはあくまで時間稼ぎです。その間に、noindexを入れるか、パスワードをかけるか、ページごと削除するか、恒久的な対応を済ませてください。
手順5|出したいページの順位が下がっていないかを見る
最後に、これがいちばん見落とされがちな確認です。noindexやrobots.txtをいじった結果、本来出したいページまで巻き込んでいないかを確かめてください。
設定は「/blog/」のようにフォルダ単位で指定することが多く、意図せず配下の記事まで対象になってしまう事故が起こります。しかも、消えたことにはすぐ気づけません。
ですから、主要なキーワードの順位を毎日記録しておくことをおすすめします。設定を変えた日と、順位が動いた日を並べて見られれば、原因の切り分けが一気に楽になります。
記録は、自分のパソコンで動かすソフトではなく、サーバー側で自動的に残る形にしておくと、確認を忘れた日の分も残ります。
よくある質問(FAQ)
Q. robots.txtとnoindexを両方使ってはいけないのですか?
同じページに対して両方を使うのは避けてください。robots.txtでクロールを止めると、Googleはページの中にあるnoindexを読めないため、指示が無視されます。これはGoogleの公式ドキュメントに明記されている仕様です。
サイト全体で見れば、robots.txtとnoindexが併存すること自体は問題ありません。管理画面のフォルダはrobots.txtで、完了ページはnoindexで、というように、対象が別であれば使い分けて構いません。
Q. noindexを入れてから、どのくらいで検索結果から消えますか?
Googleがそのページを再び巡回したタイミングで反映されます。更新頻度やサイトの規模によりますが、数日から数週間が目安です。期間を確約することはできません。
早めたい場合は、サーチコンソールのURL検査から再クロールをリクエストできます。それでもすぐに消えないときは、削除ツールで一時的に非表示にしつつ、反映を待つのが現実的です。
Q. robots.txtに「Noindex:」と書けば消せると聞きました
消せません。Googleは2019年7月の公式ブログで、robots.txt内のnoindexという記述のサポートを終了すると告知しています。2026年9月時点の公式仕様でも、サポート対象はuser-agent、allow、disallow、sitemapの4つだけです。
過去に有効だった時期があるため、古い解説記事がいまも残っています。情報の出どころが公式かどうかを確かめる習慣をつけていただくと、こうした行き違いを減らせます。
Q. 制作会社に任せています。何を確認すればいいですか?
3つだけ聞いてみてください。1つめは「検索に出したくないページは、robots.txtとnoindexのどちらで対応していますか」。2つめは「noindexを入れたページを、robots.txtでもブロックしていませんか」です。
3つめは「robots.txtにUser-agentの行がいくつありますか」。この3つに明確に答えられる相手なら、まず安心してお任せできます。
関連記事
まとめ|「通行止め」と「掲載お断り」を混ぜない
robots.txtはクロールを止めるもの、noindexはインデックスを止めるもの。止めている工程が違うので、検索結果から消したいならnoindexが正解です。Googleの公式ドキュメントも、robots.txtはページを隠すための仕組みではないと明記しています。
そして、両方を同時にかけるのは逆効果です。クロールできないページの中にあるnoindexは読まれず、無視されます。ブロックしたのに説明文なしで検索に出続ける、という状態の多くはこれが原因です。
目的別に整理すれば迷いません。絶対に見せたくないならパスワード保護、検索から消したいならnoindex、不要なら削除して404か410、重複の整理ならcanonical、PDFや画像ならX-Robots-Tagです。
今日すぐできることを1つ挙げるなら、ブラウザで自社ドメインの後ろに「/robots.txt」を付けて開いてみることです。User-agentの行が2つ以上あれば、意図せず上書きが起きていないか点検の価値があります。
そして設定を変えたあとは、出したいページの順位が巻き添えになっていないかを見届けてください。AccessScopeは、サイトのURLを入力するだけで検索順位を自動で記録し続ける無料のツールです。10キーワードまで無料、クレジットカードの登録も不要ですので、robots.txtやnoindexを触る前に、いまの順位を記録しておくところから始めてみてください。AccessScopeの無料プラン
コメント